Above#
2026的第一场CTF 也是第二场XCTF 和W&M的师傅们一起看了题 感谢Lilac师傅们5道精彩的赛题! 同时在此处也给出题人WP ↗ 进行一个引流
学到很多 被虐的很爽 感谢招待😋
NoisyForest#
chall.py
import random
import hashlib
from secret import input_str

TOTAL_BITS = 50000
huge_int = random.getrandbits(TOTAL_BITS)
def is_chinese(char):
    return '\u4e00' <= char <= '\u9fa5'

def add_unicode_noise(text, step=9997, noise_bits=1):
    noisy_text = ""
    bit_stream_segments = []
    temp_val = huge_int
    num_chunks = (TOTAL_BITS + 31) // 32
    for _ in range(num_chunks):
        chunk_val = temp_val & 0xFFFFFFFF
        bit_stream_segments.append(format(chunk_val, '032b'))
        temp_val >>= 32
    full_bit_stream = "".join(bit_stream_segments)
    stream_ptr = 0
    for char in text:
        if is_chinese(char):
            if stream_ptr + noise_bits > len(full_bit_stream):
                noisy_text += char
                continue
            chunk = full_bit_stream[stream_ptr : stream_ptr + noise_bits]
            noise_val = int(chunk, 2)
            stream_ptr += noise_bits
            original_code = ord(char)
            noisy_text += chr(original_code + (noise_val * step))
        else:
            noisy_text += char
    return noisy_text

step_val = 9997
NOISE_BITS = 1

output_str = add_unicode_noise(input_str, step=step_val, noise_bits=NOISE_BITS)

with open("ciphertext.txt", "w", encoding="utf-8") as f:
    f.write(output_str)

flag_hash = hashlib.sha256(input_str.encode('utf-8')).hexdigest()
print(f"LilacCTF{{{flag_hash}}}")


# LilacCTF{df0xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx}一道结合随机数的混淆
系统简要可以概括为对于随机的bit 来决定对于中文字符是否进行9997的偏移 大部分情况下 中文字符通过9997的偏移后不会再是中文 而我们的input_str通过推断可以大概划分为 自然中文 + 夹杂中文乱码 + 自然中文三个部分 我们可以对首和尾两个Part 把所有的乱码减去9997 恢复初步的自然中文
但是此时我们注意到 部分中文加上9997偏移还是得到中文 这个时候就需要LLM审计这两段的文本 给出偏移前后 但是同为中文的部分 这部分的Perplexity会比较高
示例如下
chunk14
idx 14096
curr 真 U+771F
alt  倒 U+5012
context …几棵小树突然[真]了下去,发出很大的响声…
altctx …几棵小树突然[倒]了下去,发出很大的响声…我们显然把”真”改回”倒”即可
赛中使用的是Gemini3-Preview 效果不错
我们恢复完首尾 大概可以得到
那些符号弯弯曲曲,就像爬动的小虫,又像风吹过沙子的痕迹,人类朋友也凑过来看,他皱起眉头,好像也不认识,老虎念出几个符号的发音,但连在一起完全不知道是什么意思,那些符号看起来是这样的,秢楠얜傻唆矍搆~~~~潳帝怖뢍癎鏖눰滛걧沍勩歾寗鮣犬栩놽뮀銴。人类朋友看着那些奇怪的字,脸色变得很严肃,他把手放在书页上,感觉到书里有一种古老而沉重的力量这样一块乱码是夹杂着中文和非中文的 我们必须要知道这里用了哪些bits才能还原回去
后半段也是和前半段类似的思路 使用偏移调整和人工审计的方法恢复 我们在这里可以得到后半段代码使用的bits流
此时我们可以通过还原MT 得到总共的bits流 前半段和后半段夹在中间的就是乱码处使用的bits流 我们逐步往前还原 就顺利恢复了所有的中文 从而完成题目
我们使用的文件
cipher.txt 密文
fixed.txt 审计后的前半段 后半段后的字符串
exp
from pathlib import Path
import hashlib
from pyrandcracker import RandCracker

STEP = 9997
TOTAL_BITS = 50000

# 乱码开头 “那些符号看起来是这样的”
START_MARKER = (
    "\u90a3\u4e9b\u7b26\u53f7\u770b\u8d77\u6765\u662f\u8fd9\u6837\u7684"
)

# 乱码结尾 “人类朋友看着那些奇怪的字”
END_MARKER = (
    "\u4eba\u7c7b\u670b\u53cb\u770b\u7740\u90a3\u4e9b\u5947\u602a\u7684\u5b57"
)

# 不参与讨论的标点符号等字符
SKIP_CHARS = {
    "\u3002",  # 。
    "\u3001",  # 、
    "\uff0c",  # ,
    "\u201c",  # “
    "\u201d",  # ”
    "\u2018",  # ‘
    "\u2019",  # ’
    "\u2026",  # …
    "\u2014",  # —
    "\uff01",  # !
    "\uff1f",  # ?
    "\uff1a",  # :
    "\uff1b",  # ;
    "\uff08",  # (
    "\uff09",  # )
    "\u300a",  # 《
    "\u300b",  # 》
    ",",
    ".",
    "!",
    "?",
    ":",
    ";",
}


def is_zh(ch: str) -> bool:
    return "\u4e00" <= ch <= "\u9fa5"


def derive_bit(plain_ch: str, cipher_ch: str) -> str:
    if plain_ch == cipher_ch:
        return "0"
    if ord(plain_ch) + STEP == ord(cipher_ch):
        return "1"
    return "?"


def should_consume(ch: str) -> bool:
    if ch.isspace():
        return False
    if ch in SKIP_CHARS:
        return False
    return True


def main() -> None:
    plain_path = Path("fixed.txt")
    cipher_path = Path("ciphertext.txt")
    out_path = Path("input.txt")

    plain = plain_path.read_text(encoding="utf-8")
    cipher = cipher_path.read_text(encoding="utf-8")

    if len(plain) != len(cipher):
        raise SystemExit(f"length mismatch: {len(plain)} vs {len(cipher)}")

    # 定位到要还原的乱码部分
    start_idx = plain.find(START_MARKER)
    end_idx = plain.find(END_MARKER)
    if start_idx < 0 or end_idx < 0:
        raise SystemExit("markers not found")

    # 处理乱码部分的标点以及空白
    start_after = start_idx + len(START_MARKER)
    while start_after < len(plain) and (
        plain[start_after].isspace() or plain[start_after] in SKIP_CHARS
    ):
        start_after += 1

    # 使用前段部分的bit还原MT
    prefix_bits = []
    for p, c in zip(plain[:start_after], cipher[:start_after]):
        if is_zh(p):
            prefix_bits.append(derive_bit(p, c))

    need_bits = 624 * 32
    if len(prefix_bits) < need_bits:
        raise SystemExit("not enough prefix bits to recover MT")
    if "?" in prefix_bits[:need_bits]:
        raise SystemExit("unknown bit in MT recovery prefix")

    words = [
        int("".join(prefix_bits[i * 32 : (i + 1) * 32]), 2)
        for i in range(624)
    ]
    rc = RandCracker()
    for w in words:
        rc.submit(w)
    rc.check()

    # 由MT预测完整的比特流
    num_chunks = (TOTAL_BITS + 31) // 32
    rem = TOTAL_BITS % 32
    pred_words = words[:] + [rc.rnd.getrandbits(32) for _ in range(num_chunks - 624)]
    if rem:
        mask = (1 << rem) - 1
        pred_words[-1] &= mask
    pred_bits = "".join(f"{w:032b}" for w in pred_words)

    # 由前后段已知的前缀和后缀寻找所求乱码部分使用的比特流
    suffix_bits = []
    for p, c in zip(plain[end_idx:], cipher[end_idx:]):
        if is_zh(p):
            suffix_bits.append(derive_bit(p, c))
    if "?" in suffix_bits:
        raise SystemExit("unknown bits in suffix; add handling")

    pattern = "".join(suffix_bits)
    match_idx = pred_bits.find(pattern)
    if match_idx < 0:
        raise SystemExit("suffix pattern not found in predicted bits")
    if pred_bits.find(pattern, match_idx + 1) != -1:
        raise SystemExit("suffix pattern not unique; add disambiguation")

    prefix_count = len(prefix_bits)
    suffix_start = match_idx
    unknown_len = suffix_start - prefix_count
    if unknown_len < 0:
        raise SystemExit("negative unknown length")
    unknown_bits = pred_bits[prefix_count:suffix_start]

    # 由使用比特流和cipher中的乱码 还原input中的乱码部分
    plain_unknown = plain[start_after:end_idx]
    cipher_unknown = cipher[start_after:end_idx]

    bit_iter = iter(unknown_bits)
    decoded_unknown_chars = []
    used = 0
    for p_ch, c_ch in zip(plain_unknown, cipher_unknown):
        if should_consume(p_ch):
            try:
                b = next(bit_iter)
            except StopIteration:
                raise SystemExit("ran out of bits while decoding unknown region")
            used += 1
            if b == "1":
                decoded_unknown_chars.append(chr(ord(c_ch) - STEP))
            else:
                decoded_unknown_chars.append(c_ch)
        else:
            decoded_unknown_chars.append(c_ch)

    remaining = sum(1 for _ in bit_iter)

    out_text = plain[:start_after] + "".join(decoded_unknown_chars) + plain[end_idx:]
    out_path.write_text(out_text, encoding="utf-8")


    print("prefix_bits", prefix_count)
    print("suffix_start", suffix_start)
    print("unknown_bits_len", unknown_len)
    print("bits_used_in_unknown", used)
    print("bits_remaining_after_unknown", remaining)
    print("output", out_path)
    print("flag", f"LilacCTF{{{hashlib.sha256(out_text.encode('utf-8')).hexdigest()}}}")


if __name__ == "__main__":
    main()

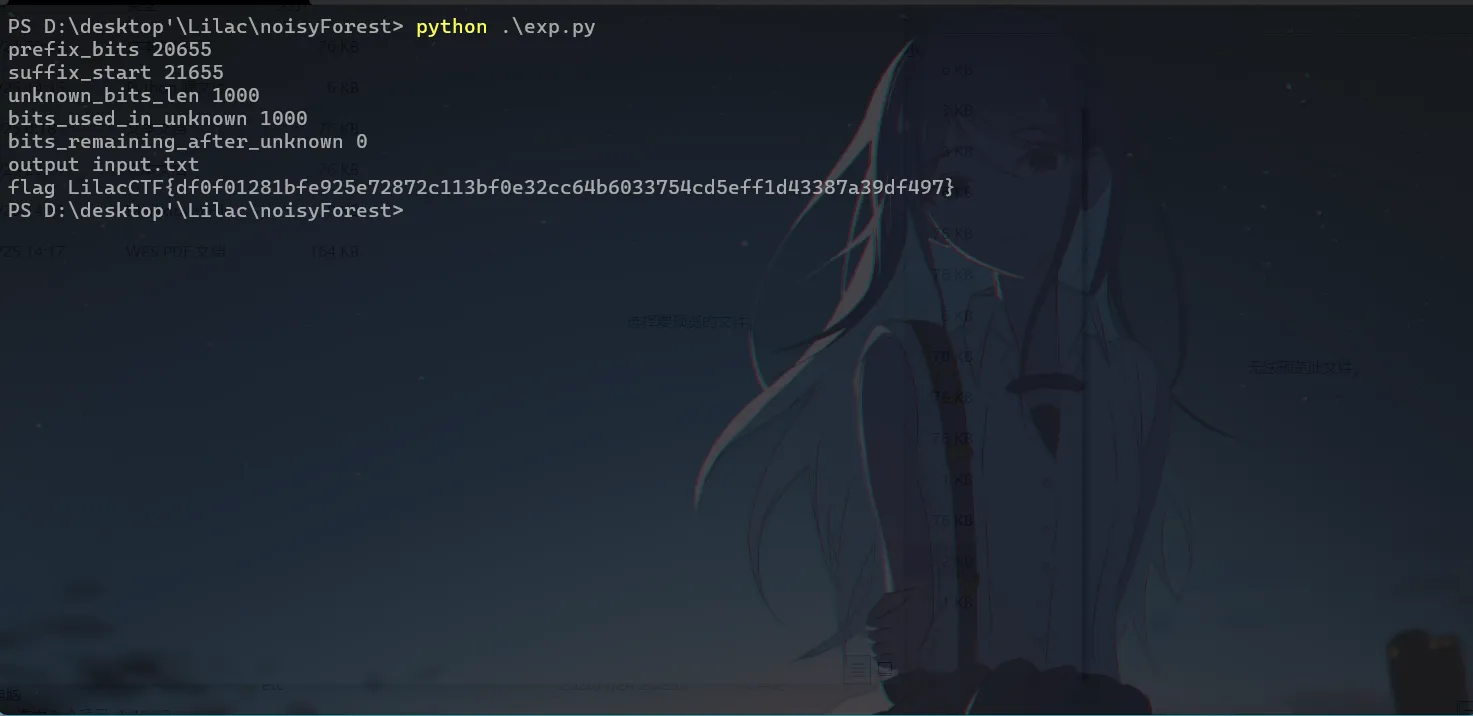
'''
prefix_bits 20655
suffix_start 21655
unknown_bits_len 1000
bits_used_in_unknown 1000
bits_remaining_after_unknown 0
output input.txt
'''
nestDLP#
chall.py
from sage.all import PolynomialRing, Zmod
from Crypto.Util.number import getPrime
from random import SystemRandom

random = SystemRandom()


def otp(bitlen: int) -> int:
  half_len = bitlen // 2
  left = ["0"] * (half_len - 1)
  right = ["1"] * (half_len + 1)
  bits = left + right
  random.shuffle(bits)
  return int("".join(bits), 2)


def get_exps(msg: bytes, nums: int) -> list[int]:
  exps = []
  blen = len(msg) * 8
  m = int.from_bytes(msg, "big")
  for _ in range(nums):
    padding = otp(blen)
    exps.append(m ^ padding)
  return exps


if __name__ == "__main__":
  flag = open("flag.txt", "rb").read().strip()
  assert flag.startswith(b"LilacCTF{") and flag.endswith(b"}")
  flag = flag[9:-1]
  exps = get_exps(flag, 384)
  p = getPrime(384)
  R = PolynomialRing(Zmod(p**3), names="x,y")
  x, y = R.gens()
  I = R.ideal([x**3 + y**5 + 13 * x * y - 37, y**3 + x**5 + 37 * x - 13])  # noqa: E741
  S = R.quotient(I, names=("x,y"))
  g = S(x**2 + y**2 + 13 * x + 37 * y + 1337)
  print(p)
  for e in exps:
print(g**e)两个部分组合而成的一道问题
Part1#
需要我们从题目给出的商环上做离散对数 还原
这里问题在多变元商环上计算模幂 模数为 考虑先将复杂的代数结构映射回整数环 再通过整环的来求解DLP
DexterJie师傅和Swizzer师傅分别考虑了两种映射手法 在这里记录
行列式映射#
首先先看这两段代码
def projected_basis(I, p):  # noqa: E741
  R = I.ring()
  names = R.variable_names()
  Rfp = PolynomialRing(GF(p), names=names)
  Ifp = Rfp.ideal([Rfp(f) for f in I.gens()])
  basis_fp = Ifp.normal_basis() # 在mod p上寻找一组基
  xs = R.gens()
  basis = []
  for m in basis_fp:
    exps = m.exponents()[0]
    mon = prod(x**e for x, e in zip(xs, exps))
    basis.append(mon)
return basis它的目的是在商环结构上找到一组基 便于往后表示商环运算中的元素 值得注意的是即使商环定义在模上 一组模上的有效基也可以通过Lifting而得到模的一组有效基
def get_matrix(element, quotient_ring, p):
  I = quotient_ring.defining_ideal()  # noqa: E741
  base_ring = quotient_ring.base_ring()
  basis = projected_basis(I, p)
  g_poly = element.lift()
  matrix_cols = []

  for b in basis:
    prod_poly = g_poly * b
    reduced_poly = quotient_ring(prod_poly).lift()
    coeffs = [reduced_poly.monomial_coefficient(mon) for mon in basis]
    matrix_cols.append(coeffs)

  M = matrix(base_ring, matrix_cols).transpose()
return M这里是把商环上的点向矩阵映射的关键 我们来分析 我们商环上的元素毕竟还是系数点 也就是 而我们选定的一组基就可以看成这样的一个基点 对于我们商环上的运算 在系数的下 仍然可以看成一个线性系统 也就是加减乘和对取模 而的处理也具备严格线性 所以说我们商环上的任何点 都可以看成基点做了一个线性变换得到 而且线性变换的本质就可以看成矩阵乘法,我们把商环上的元素看成行向量 那么有
在DLP的代数系统中 我们选取的元素基本上不会包含有关的信息 故而可以认为是可逆的 那么对于商环上的计算
可以视为
我们也就把商环上的复杂元素映射到了矩阵乘法 而我们也有
此时就有
这样我们就把问题转化为了在上的整数DLP问题 可以考虑如下快速的求法
def padic_dlp(g: int, y: int, p: int, s: int):
  def theta(k, p, s):
    return (pow(k, (p - 1) * p ** (s - 1), p ** (2 * s - 1)) - 1) // (p**s)

  g, y, p, s = int(g), int(y), int(p), int(s)
return pow(theta(g, p, s), -1, p ** (s - 1)) * theta(y, p, s) % (p ** (s - 1))它针对的是
我们知道
对于任意满足的 都有
也就是
所以我们的theta函数干的就是
令
所以说
二项式展开 超过直接约 得到
那么
我们这里的不就是吗 那么
求值同态#
为了理解这个方法 我们需要稍微理解商环的运算过程
商环上不同的元素实际上对应的是一个个不同的系数多项式 我们商环上的变元可以带入其中 计算得到对应的,那么我们在商环上对元素进行计算 也就是对系数之间进行线性处理;而我们的理想I就可以理解为这样两个特殊的多项式 满足对于所有的变元 它们在商环的模运算下被归类到 也就是在 中
此时元素等价
我们希望找到一个映射 使得商环上的元素能够和整数一一对应 也就是
我们把商环的元素多项式带入 它对应一个标量整数 我们来看看要满足什么性质 可知如果
一定有
那么如果想要满足这个映射关系 就很容易发现 有
且
此时对于这个点 我们可以把商环元素和整数一一对应
我们先求出模下的一组 采用的是一种消元的思想 这里的代数式度并不高 可以借由理想的限制完成降次消元工作
R_fp = PolynomialRing(GF(p), names="x,y")
x_fp, y_fp = R_fp.gens()
f1_fp = x_fp**3 + y_fp**5 + 13 * x_fp * y_fp - 37
f2_fp = y_fp**3 + x_fp**5 + 37 * x_fp - 13
I_fp = R_fp.ideal([f1_fp, f2_fp])
Iy = I_fp.elimination_ideal([x_fp])
poly_y = Iy.gens()[0]
Ry = PolynomialRing(GF(p), 'y')
py = Ry(poly_y)
y_roots_pair = py.roots()随后对于解一元方程得到的解进行遍历 来找到一组可以用的解
roots = []
for r_val_y, _ in y_roots_pair:
    Rx = PolynomialRing(GF(p), 'x')
    fx1 = Rx(f1_fp.subs(y=r_val_y))
    fx2 = Rx(f2_fp.subs(y=r_val_y))
    x_roots_pair = fx1.roots()
    for r_val_x, _ in x_roots_pair:
        if fx2(r_val_x) == 0:
roots.append({'x': r_val_x, 'y': r_val_y})然后就是Hensel-Lifting来提升解 这个基本上都很公式 核心思路就是牛顿迭代/泰勒展开式
这里给出Gemini3老师的公式分析
Hensel Lifting(亨泽尔引理提升) 在这种场景下确实是固定、公式化且极其自然的步骤。 这就像我们在解方程时使用的“牛顿迭代法”:一旦你有了一个粗糙的近似解(Mod ),你就可以通过一套固定的公式,一步步把它打磨成高精度的解(Mod )。
为什么说是“自然的”? 因为代数结构通常具有局部性质。 一个方程 的解,往往暗示了在 的邻域内(即模 )存在一个更精确的解。只要这个点不是“奇异点”(导数不为0),这种提升就是唯一且确定的。
提升的公式(多元牛顿迭代) 我们要解方程组:
公式如下:
假设 是模 下的解。 我们想求 使得它是模 (或者 )下的解
也就是
这里的核心组件是
当前的解
: 当前解代入方程后的残差**(Residual) **
- 因为 是模 的解,所以 一定是 的倍数
: 雅可比矩阵 (Jacobian Matrix)在点 处的值。 我们需要计算这个矩阵的逆矩阵。
代码实现
prec = 3
cur_x, cur_y = r_x, r_y
for k in range(1, prec):
    mod_k = p**k
    val1 = (cur_x**3 + cur_y**5 + 13 * cur_x * cur_y - 37)
    val2 = (cur_y**3 + cur_x**5 + 37 * cur_x - 13)
    v1 = (val1 // mod_k) % p
    v2 = (val2 // mod_k) % p
    vec_f = vector(GF(p), [v1, v2])
    cx = GF(p)(cur_x)
    cy = GF(p)(cur_y)
    j11 = 3 * cx**2 + 13 * cy
    j12 = 5 * cy**4 + 13 * cx
    j21 = 5 * cx**4 + 37
    j22 = 3 * cy**2
    J = Matrix(GF(p), [[j11, j12], [j21, j22]])
    delta = J.solve_right(-vec_f)
    cur_x += int(delta[0]) * (p**k)
cur_y += int(delta[1]) * (p**k)随后就是愉快的p-adic
part2#
恢复exps后 我们发现它是576bits 说明要求的flag也是576bits 但是我们只有384组的padding 未知数规模比较大 得考虑格规约
赛中第一时间想到的是2022SEECTF的Neutrality ↗
这里稍微有所改动
pads的汉明重量是2 而不是0
flag长为576Bits 而我们只有384组已知的Bits
首先映射的思路是可以通用的
为什么这里优先考虑映射?
主要是pads汉明重量不为0 如果是一半0 一半1 利用Bits的分布规律 一半的异或结果与flag相同 另一半不同确实可以得到
但是这里可惜不是 所以说右边的常量会有多种可能 但是我们映射到乘法后 就直接可以得到
我们可以这样理解
这个运算系统下 也就是
而中 1比0多两个 就得到了上述的方程
然后我们知道flag的72字节 肯定是可打印可读ASCII 那么最高位的比特一定是 0 映射后是1
所以说我们相当于知道了72比特的 也就是
384组线性约束 求解504个未知量 其中未知量都是1或者-1的小量 这个比规约0和1更好
也就是在线性系统
中 我们知道 它就是384组exp 也知道 它是
我们该如何去求?
我们直观的看这个线性系统
504个变量,384组约束 说明 自由变量只有120个 也就是这120个非常小的自由变量决定了整个线性系统 我们把这个些自由变量称为线性系统的核 列式子就是
我们虽然知道
也能找到一组特解 这个不难 满足
做差就有
此时我们知道 既然我们的自由变量只有120个 那么线性系统中所有的504长度向量均可表示为120 个基向量 每个基向量是的整数线性组合:
其中 是整数系数。
回代 那么有
这样子 我们就完成了降维 从找504维的 到去找120维的
我们不知道系数 是多少,但我们知道 很短(全为 )。 我们要构造一个格,使得格子里包含 这个向量。 我们构造一个 的矩阵 。 每一行代表一个格基向量:
当我们对矩阵 进行线性组合时,格空间里的向量 长这样:
我们要求 但是我们把放入我们的目标向量 而是让它在规约过程中 给我们的实际小量带出来 这样子就顺利规约了!
我们的伪代码思路如下
# 1. 求解特解 (504维)
f0 = A.solve_right(e)

# 2. 求解核基 (120行 x 504列) -> 降维的关键
K = A.right_kernel().matrix()

# 3. 构造格矩阵
# [ K   0 ]
# [ f0  1 ]

upper_part = block_matrix([K, matrix(ZZ, K.nrows(), 1)])

lower_part = block_matrix([matrix(ZZ, f0), matrix(ZZ, [1])])

Lattice_Basis = block_matrix([[upper_part], [lower_part]])

# LLL 会自动调整系数 x_i,使得最终向量最短
Reduced_Basis = Lattice_Basis.LLL()

# Reduced_Basis[0] 应该就是 (Flag_vector, 1)exp
from sage.all import *
from Crypto.Util.number import *

exps =

n_bits = 576
k = n_bits // 2 + 1

known = {8*i + 7: 0 for i in range(n_bits // 8)}
unknown = [i for i in range(n_bits) if i not in known]

m = len(exps)
A = Matrix(ZZ, m, len(unknown))
b = vector(ZZ, m)
rhs_base = n_bits - 2 * k  # = -2

for i, e in enumerate(exps):
    e_int = int(e)
    row_full = [1 - 2 * ((e_int >> j) & 1) for j in range(n_bits)]
    rhs = rhs_base - sum(row_full[idx] for idx in known)
    for col, idx in enumerate(unknown):
        A[i, col] = row_full[idx]
    b[i] = rhs

D, U, V = A.smith_form()
r = A.rank()
K = V[:, r:].transpose()

ub = U * b
y = [0] * A.ncols()
for i in range(r):
    y[i] = ub[i] // D[i, i]
x_p = V * vector(ZZ, y)

B = block_matrix([
    [K, zero_matrix(ZZ, K.nrows(), 1)],
    [matrix(ZZ, [x_p]), matrix(ZZ, [[1]])],
])
B = B.LLL()

row = next(r for r in B if int(r[-1]) in (1, -1))
last = int(row[-1])
cand = [int(x * last) for x in row[:-1]]

full = [0] * n_bits
for idx in known:
    full[idx] = 0
for idx, v in zip(unknown, cand):
    full[idx] = 0 if v == 1 else 1

m_int = 0
for i, bit in enumerate(full):
    if bit:
        m_int |= (1 << i)

msg = long_to_bytes(m_int, n_bits // 8)
print(f"LilacCTF{{{msg.decode()}}}")

# LilacCTF{l1Ft3d_p0lyn0m1Al_R1nG_and_maTh3m4t1cs_sk1LLs_bu1ld_Lilac_flav0r_1n_2026}值得注意的是 这里LLM给出了提取kernel更优化的一种方法
D, U, V = A.smith_form()
r = A.rank()
K = V[:, r:].transpose()这里也贴下Gemini老师的分析
这段代码是利用 Smith Normal Form (SNF, 史密斯标准型) 来手动提取矩阵 的 整数核空间(Integer Kernel) 的基底。
这是比直接调用
.right_kernel()更底层、更具几何直观性的做法,能确保我们得到的是**饱和(Saturated)**的整数基。下面我一步步带你拆解这个数学过程:
- 核心公式:坐标变换
SageMath 的
A.smith_form()返回三个矩阵 ,满足以下恒等式:其中:
:原始系数矩阵 ()。
:对角矩阵(Diagonal Matrix)。只有对角线上有非零元素,其他全是 0。
:左变换矩阵,代表行变换(在这个问题里不重要)。
:右变换矩阵,代表列变换。这是一个 单模矩阵(Unimodular Matrix),意味着它在整数域上可逆(行列式为 )。
推导:为什么 的后几列就是核?
我们的目标是解齐次方程:
利用 SNF 公式 ,我们可以把 反解出来(因为 都可逆):
代入方程 :
两边同时左乘 ( 是可逆的,不会改变方程的解):
这里我们做一个精妙的换元(坐标变换): 令 ,也就是 。 此时方程变成了极其简单的形式:
- 分析 的解结构
矩阵 是 Smith 标准型,它的长相是这样的:
其中 是矩阵的秩(Rank),前 个对角元素非零,第 行之后全为 0。
我们要解 ,其中 。 展开来看就是:
因为 都是非零整数,所以必须有 。 但是! 到 对应的方程是 ,所以它们可以是任意整数!
所以, 的通解形式一定是: 只有后 个分量是非零自由变量。
- 还原回 (Key Step)
记得我们定义的 吗? 这就意味着 是矩阵 的列向量的线性组合。
由矩阵乘法规则,前 列 都被 0 乘掉了。 结果只剩下:
结论: 矩阵 的第 列之后的所有列,就是核空间的一组基底!
- 代码逐行解释
python# 1. 计算 Smith 标准型 # D 是对角阵,V 是列变换矩阵 D, U, V = A.smith_form() # 2. 获取矩阵的秩 r # 这告诉我们要丢掉前 r 列,因为它们对应非零的主元,被方程锁死为 0 了 r = A.rank() # 3. 提取核空间基底 # V[:, r:] --> 切片操作:取 V 的所有行,但只取从第 r 列开始到最后的列 # .transpose() --> Sage 中通常习惯用行向量表示基底,所以转置一下 K = V[:, r:].transpose()总结:为什么要这样做?
相比于直接用高斯消元求核,利用 Smith Form 的 矩阵有极其重要的优势:
单模性(Unimodular): 矩阵 的行列式是 。这意味着它张成的格(Lattice)是完备的整数格(Saturated Lattice)。 这保证了我们提取出的基向量 能够通过整数线性组合生成核空间里的每一个整数向量。
如果用普通的行阶梯形(RREF)求核,有时会得到分数基,去分母后可能会导致格变得稀疏(丢失了解)。而 SNF 方法是求解此类整数方程最稳健的方法。
直接用鸡块的方法 做一个 的SVP也可以 用flatter加速可以规约出来 具体参考 星盟在这里的做法LilacCTF 2026 Writeup - 星盟安全团队 (xmcve.com) ↗
预期解使用的是
from ortools.sat.python import cp_model有点类似z3 是在已知约束的情况下去寻找可行解的工具 比z3快不少)
记几个工具 后面研究下怎么用
keeganryan/cuso (github.com) ↗
*myRSA#
import gmpy2
from Crypto.Util.number import isPrime, bytes_to_long
from sympy.ntheory import sqrt_mod
from sympy.ntheory.modular import crt
from secret import p, q, r, pp
import os

def oracle(x):
  root_p = sqrt_mod(x, p)
  root_q = sqrt_mod(x, q)
  root_r = sqrt_mod(x, r)
  if root_p is None or root_q is None or root_r is None:
    return "🤐"
  ans, _ = crt([p, q, r], [root_p, root_q, root_r])
  return int(ans)

assert p == pp**2 + 3 * pp + 3 and q == pp**2 + 5 * pp + 7
assert isPrime(p) and isPrime(q) and isPrime(r)

m = bytes_to_long(os.getenv("FLAG", "LilacCTF{fake_flag}").encode().strip())
n = p * q * r
e = 65537
c = pow(m, e, n)

print(f"{n = }")
print(f"{c = }")

while True:
  x = int(input("🧭 > "))
  _, is_psq = gmpy2.iroot(x, 2)
  assert not is_psq, "👿"
  assert 80 < x < 100
  print(oracle(x))

'''
n = 320463398964822335046388577512598439169912412662663009494347432623554394203670803089065987779128504277420596228400774827331351610218400792101575854579340551173392220602541203502751384517150046009415263351743602382113258267162420601780488075168957353780597674878144369327869964465070900596283281886408183175554478081038993938477659926361457163384937565266894839330377063520304463379213493662243218514993889537829099698656597997161855278297938355255410088350528543369288722795261835727770017939399082258134647208444374973242138569356754462210049877096486232693547694891534331539434254781094641373606991238019101335437
c = 80140760654462267017719473677495407945806989083076205994692983838456863987736401342704400427420046369099889997909749061368480651101102957366243793278412775082041015336890704820532767466703387606369163429880159007880606865852075573350086563934479736264492605192640115037085361523151744341819385022516548746015224651520456608321954049996777342018093920514055242719341522462068436565236490888149658105227332969276825894486219704822623333003530407496629970767624179771340249861283624439879882322915841180645525481839850978628245753026288794265196088121281665948230166544293876326256961232824906231788653397049122767633
x = 96
res = 34484956620179866074070847926139804359063142072294116788718557980902699327115656987124274229028140189100320603969008330866286764246306228523522742687628880235600852992498136916120692433600681811756379032521946702982740835213837602607673998432757011503342362501420917079002053526006602493983327263888542981905944223306284758287900181549380023600320809126518577943982963226746085664799480543700126384554756984361274849594593385089122492057335848048936127343198814676002820177792439241938851191156589839212021554296197426022622140915752674220260151964958964867477793087927995204920387657229909976501960074230485827919

'''未出解🤕 即使到最后也没能找到正确的方向ww
给出一个rsa系统 其模数具有特殊的代数结构
其中
这里的oracle允许输入一个观察其对于是否同时满足二次剩余并且开根 经测试只有能够返回一个res
从我们之前熟知的Pollard p-1算法出发 我们本质是找到了群的阶的倍数 也就是 此时用阶的倍数进行模幂运算 就能够返回一个单位元 从而构造一个非平凡的的结构因子 也就是
所以说我们分解的思路都是去找一个满足特别代数结构的运算群 它的阶的信息我们能够直接或者间接的得到 然后在利用阶相关的运算中 得到关于模数的非平凡因子
这里基于ECM的分解 或者是另一种基于分圆多项式的分解
的分解都是寻找一个已知阶的运算群
话说回来 我们的不难看成
接下来我们计算的判别式
由一元二次方程求根公式产生负数的情况 我们可以知道此时方程的根能够表示为
所以说由求根公式 我们可以得到
通过LLM 我们知道当我们的素数满足这种特殊的代数结构 那么对于一条模的椭圆曲线 它就具备了**复乘(CM)**性质
为什么要提到这个复乘?
因为具备复乘性质的椭圆曲线 它的阶我们可以直接得到
如何判断一条椭圆曲线是否具备复乘?
对于椭圆曲线 如果它的模数满足类似性质
是一个任意的整数
那么满足的复乘 此时根据的取值可以构造一条特殊结构的椭圆曲线 在这条曲线上
是曲线的迹(trace)
复乘怎么用?
我们由复乘可以算出曲线的迹 这在普通曲线中是做不到的 而对于任意曲线 它的阶可以表示为
这里给出复乘不同的针对曲线的构造表格
| 值 | 判别条件 () | 曲线方程形式 / 标准方程 | j-invariant (整数值) | 备注 / 值特征 |
|---|---|---|---|---|
| 3 | ||||
| 4 | ||||
| 7 | ||||
| 8 | ||||
| 11 | 由 j 生成 | |||
| 19 | 由 j 生成 | |||
| 43 | 由 j 生成 | |||
| 67 | 由 j 生成 | |||
| 163 | 由 j 生成 |
只要确定了 变换,可以通过以下系数构造曲线 :
其中 是缩放因子。通常在 SageMath 中,可以直接使用 EllipticCurve_from_j(j) 命令一键生成。
说回本题
所以说此时我们知道 对于模或者模的椭圆曲线 它具备的复乘性质 我们构造特殊的曲线
- 对于 由1式我们可以得到它的迹为 可以计算阶 对于曲线的扭曲镜像 我们有
- 对于 由1式我们可以得到它的迹为 可以计算阶 对于曲线的原像 我们有
那么我们也就完全符合了前文提到的 构造一个已知阶关系的运算群的要求了
我们知道我们要构造的椭圆曲线形如 这里可以随便取 但是我们注意oracle输入会返回一个res 那不就是
所以说我们可以知道
对于不同的 我们可以构造曲线 然后得到一个曲线上的点 然后进行后续的操作 经测试 和都能很好的完成分解 我推测是这两条曲线的阶恰好满足上面的互为对方模数的关系
好的 我们接下来就已知曲线 还有它上面的点 我们知道 也一定在 上 此时我们去计算
因为我们知道一定是阶的倍数 那么在椭圆曲线中 对一个点进行阶的点乘 就会得到无穷远点 也就是
在sagemath中这个运算会失败
底层上来看 我们在模域下 某步计算后会得到0 但是别的域下不会得到 那么我们在点加求斜率的过程中 涉及除法就会失败 也就是模逆计算失败
此时我们手动追踪除法的因子 做 即可求出来 这也就是
Lenstra elliptic-curve factorization.
exp
from Crypto.Util.number import long_to_bytes, inverse
import math

# 题目数据
n = 320463398964822335046388577512598439169912412662663009494347432623554394203670803089065987779128504277420596228400774827331351610218400792101575854579340551173392220602541203502751384517150046009415263351743602382113258267162420601780488075168957353780597674878144369327869964465070900596283281886408183175554478081038993938477659926361457163384937565266894839330377063520304463379213493662243218514993889537829099698656597997161855278297938355255410088350528543369288722795261835727770017939399082258134647208444374973242138569356754462210049877096486232693547694891534331539434254781094641373606991238019101335437
res = 34484956620179866074070847926139804359063142072294116788718557980902699327115656987124274229028140189100320603969008330866286764246306228523522742687628880235600852992498136916120692433600681811756379032521946702982740835213837602607673998432757011503342362501420917079002053526006602493983327263888542981905944223306284758287900181549380023600320809126518577943982963226746085664799480543700126384554756984361274849594593385089122492057335848048936127343198814676002820177792439241938851191156589839212021554296197426022622140915752674220260151964958964867477793087927995204920387657229909976501960074230485827919
c = 80140760654462267017719473677495407945806989083076205994692983838456863987736401342704400427420046369099889997909749061368480651101102957366243793278412775082041015336890704820532767466703387606369163429880159007880606865852075573350086563934479736264492605192640115037085361523151744341819385022516548746015224651520456608321954049996777342018093920514055242719341522462068436565236490888149658105227332969276825894486219704822623333003530407496629970767624179771340249861283624439879882322915841180645525481839850978628245753026288794265196088121281665948230166544293876326256961232824906231788653397049122767633
e = 65537

# 1. 手动实现ECM
def add(P, Q, n):
    if P is None: return Q
    if Q is None: return P
    x1, y1 = P
    x2, y2 = Q
    # 结果为无穷远点
    if x1 == x2 and (y1 + y2) % n == 0: return None
    # 计算斜率的分子和分母
    if x1 == x2:
        num, den = (3 * x1 * x1) % n, (2 * y1) % n
    else:
        num, den = (y2 - y1) % n, (x2 - x1) % n

    # 【核心】检查分母是否暴露了因子
    g = math.gcd(den, n)
    if 1 < g < n:
        raise ValueError(g) # 抛出因子

    # 正常加法逻辑
    m = (num * pow(den, -1, n)) % n
    x3 = (m * m - x1 - x2) % n
    y3 = (m * (x1 - x3) - y1) % n
    return (x3, y3)

def mul(P, k, n):
    res, base = None, P
    while k:
        if k & 1: res = add(res, base, n)
        base = add(base, base, n)
        k >>= 1
    return res

# 2. 执行攻击
print("[*] Starting ECM - CM Attack...")
G = (4, res)
try:
    mul(G, n, n)
except ValueError as e_val:
    fact = e_val.args[0]
    print(f"[+] Caught factor: {fact}")

    # 3. 恢复参数 pp, p, q, r
    # 我们知道 4p - 3 = (2pp+3)^2 或 4q - 3 = (2pp+5)^2
    # 这里的 fact 可能是 p, q, 或 pq
    def recover_all(f):
        for candidate in [f, n // f]:
            # 尝试解 4x - 3 = S^2
            S2 = 4 * candidate - 3
            S = math.isqrt(S2)
            if S * S == S2:
                # 进一步判断是 p 还是 q (对应常数项 3 或 5)
                for c_val in [3, 5]:
                    if (S - c_val) % 2 == 0:
                        pp = (S - c_val) // 2
                        p = pp**2 + 3*pp + 3
                        q = pp**2 + 5*pp + 7
                        r = n // (p * q)
                        return p, q, r
        return None

    params = recover_all(fact)
    if params:
        p, q, r = params
        print(f"[+] Recovered: p={p}, q={q}, r={r}")

        # 4. 解密
        phi = (p - 1) * (q - 1) * (r - 1)
        d = inverse(e, phi)
        flag = long_to_bytes(pow(c, d, n))
        print(f"\n[!] FLAG: {flag.decode()}")
    else:
print("[-] Parameter recovery failed.")在CTF-2025/crypto/madoka-rsa/README.md at main · infobahnctf/CTF-2025 (github.com) ↗
中 的 是 我们 mul(G, 2 * n, n)就行😇
*myBlock#
chall.py
from secrets import randbits
from cipher import myFeistel, ROUNDS
from hashlib import sha3_256
import signal
import os


def handler(_signum, _frame):
  raise TimeoutError("⏰")


def oracle(nums, subkeys):
  cipher = myFeistel(subkeys)
  pts = [(randbits(16), randbits(16)) for _ in range(nums)]
  cts = cipher.enc(pts)
  print(pts)
  print(cts)


if __name__ == "__main__":
  signal.signal(signal.SIGALRM, handler)
  signal.alarm(512)
  flag = os.getenv("FLAG", "LilacCTF{fake_flag}")
  subkeys = [randbits(16) for _ in range(ROUNDS)]
  nums = int(input("🎫 > "))
  assert nums < 675
  oracle(nums, subkeys)
  key = b"".join(subkeys[i].to_bytes(2, "big") for i in range(ROUNDS))
  print(sha3_256(key).digest().hex())
  print(subkeys[-1])
  guess = bytes.fromhex(input("🔑 > ").strip())
  assert guess == key, "💥"
  print(flag)
cipher.py
POLY = 0x1002D
ROUNDS = 8


class myFeistel:
  def __init__(self, subkeys):
    assert len(subkeys) == ROUNDS
    self.subkeys = subkeys

  @staticmethod
  def add(a, b):
    return a ^ b

  @staticmethod
  def mul(a, b):
    res = 0
    for i in range(16):
      if (b >> i) & 1:
        res ^= a

      high_bit = (a >> 15) & 1
      a = (a << 1) & 0xFFFF
      if high_bit:
        a ^= POLY & 0xFFFF
    return res

  @staticmethod
  def cube(a):
    sq = myFeistel.mul(a, a)
    return myFeistel.mul(sq, a)

  def enc_block(self, L, R):
    for k in self.subkeys:
      T = self.cube(L ^ k)
      new_R = R ^ T
      new_L = L
      L, R = new_R, new_L

    return L, R

  def enc(self, data):
    return [self.enc_block(l, r) for l, r in data]  # noqa: E741
一个定义在8轮Feistel网络上的分组加密
处理过程为
我们可以选取nums组数据进行加密 要求从已有的数据中恢复16*8bits的subkeys
母题是corCTF 2023 - Superbox (crypto) (affine.group) ↗
我们知道输进去 和传出来的数据 可以考虑MITM攻击 从输入开始加密 从输出开始解密 如果在中间产生了碰撞 说明结果正确
corCTF2023这道题需再下解6个子密钥 而且轮函数是 我们可以理解为加密不过是一个8次的多项式运算 解密也是类似 这个线性系统可以直接被GrobnerBasis找到一组碰撞
但是在这道Myblock中 轮函数是3次 而且是4轮的MITM Grobner足足有81次 基本不可解
而且LLM在看到会尝试用z3 这更不可能考虑得到解了 启发式算法在这个问题规模下基本不可能得到答案
通过阅读https://rbtree.blog/posts/2022-11-07-interpolation-attack/ ↗ 我们来分析下什么是块密码上的插值攻击
块密码上的多项式插值攻击#
理论基础#
- 在我们的分组加密过程中 虽然密钥是未知的 但它是固定的 也就是我们可以把它看成在题目规定有限域上的常数
- 在分组加密过程中 我们进行的不论是还是还是立方本质上都可以看成有限域上的线性变换 所以说任何系统中的变换都可以看成一个对系数的多元多项式处理 也就是 系数 是由未知密钥 决定的常数
- 直接求解会由于问题规模产生困难 我们把目光转向尝试求解 只要解出所有的多项式系数 也就相当于还原了加密 解密的过程
实现细节#
- 对于度数为的多项式 我们想恢复它肯定要尝试有至少组的 数学上多项式是唯一的 但是我们在MITM中处理的实际上是方程 这里的未知量是 多项式的系数 也就是处理线性系统 我们可以多收集数据 让关于的解收敛到唯一
- 本题中轮函数是3次 我们使用类似MITM的思路 分别做两边的4轮Feistel加密/解密 我们的多项式的度是81 相当于要解82个项 而我们可以获得最多674组的约束
求解#
本题中
print(subkeys[-1])直接给出了第7轮密钥 可以打一个前向加密4轮 后向解密3轮的MITM 用代数多项式化的方法 拿足够的约束去插值 尝试还原出多项式后对每轮key进行一个搜索
这里参考星盟的师傅 用Cpp写了运算组件 然后用python做交互 调用可执行程序求解 exp to be done 😶
BootsTrapping#
ckks
chall.cpp
#include "seal/seal.h"
#include "seal/util/ntt.h"
#include <iostream>
#include <vector>
#include <fstream>
#include <cmath>
#include <cassert>
using namespace std;
using namespace seal;
using namespace seal::util;

uint64_t inverse(uint64_t a, uint64_t m) {
    int64_t t = 0, newt = 1;
    int64_t r = m, newr = a;
    while (newr != 0) {
        int64_t quotient = r / newr;
        t = t - quotient * newt; swap(t, newt);
        r = r - quotient * newr; swap(r, newr);
    }
    if (t < 0) t += m;
    return (uint64_t)t;
}


string flag = "LilacCTF{XXXXXXXXXXXXXXX}";
int main() {
    EncryptionParameters parms(scheme_type::ckks);
    size_t n = 4096;
    parms.set_poly_modulus_degree(n);
    auto coeff_modulus = CoeffModulus::Create(n, { 30, 30, 30 });
    parms.set_coeff_modulus(coeff_modulus);
    SEALContext context(parms);


    KeyGenerator keygen(context);
    SecretKey secret_key = keygen.secret_key();

    PublicKey public_key;
    keygen.create_public_key(public_key);


    Encryptor encryptor(context, public_key);
    Decryptor decryptor(context, secret_key);
    CKKSEncoder encoder(context);
    Evaluator evaluator(context);

    vector<double> input;

    for(int i = 0; i < flag.size(); i++){
        input.push_back(1.0*flag.at(i)/256);
    }

    for(int i = flag.size(); i < 50; i++){
        input.push_back(0.5);
    }
    double scale = pow(2.0, 20);
    Plaintext pt_init, pt_mask;
    encoder.encode(input, scale, pt_init);
    encoder.encode(0, scale, pt_mask);

    Ciphertext ct, ct_mask;
    encryptor.encrypt(pt_init, ct);
    encryptor.encrypt(pt_mask, ct_mask);

    evaluator.add_inplace(ct,ct_mask);
    ofstream fs_ct("ciphertext.dat", ios::binary);
    ct.save(fs_ct);
    fs_ct.close();

    ofstream fs_ct_mask("ciphertext_mask.dat", ios::binary);
    ct_mask.save(fs_ct_mask);
    fs_ct_mask.close();


    while (context.get_context_data(ct.parms_id())->next_context_data()) {
        evaluator.mod_switch_to_next_inplace(ct);
    }

    auto context_low = context.get_context_data(ct.parms_id());
    auto context_high = context.get_context_data(context.first_parms_id());
    auto &mod_high = context_high->parms().coeff_modulus();
    int q_low = context_low->parms().coeff_modulus().back().value();

    Ciphertext ct_high;
    ct_high.resize(context, context.first_parms_id(), ct.size());
    evaluator.transform_from_ntt_inplace(ct);

    for (size_t poly_idx = 0; poly_idx < ct.size(); poly_idx++) {
        for (size_t i = 0; i < n; i++) {
            uint64_t raw_val = *(ct.data(poly_idx) + i);
            for (size_t rns_idx = 0; rns_idx < mod_high.size(); rns_idx++) {
                uint64_t qi = mod_high[rns_idx].value();
                *(ct_high.data(poly_idx) + (rns_idx * n) + i) = raw_val % qi;
            }
        }
    }
    ct_high.is_ntt_form() = false;
    ct_high.scale() = ct.scale();

    evaluator.transform_to_ntt_inplace(ct_high);
    Plaintext pt_kq;
    decryptor.decrypt(ct_high, pt_kq);

    for (size_t rns_idx = 0; rns_idx < mod_high.size(); rns_idx++) {
        inverse_ntt_negacyclic_harvey(pt_kq.data() + (rns_idx * n), context_high->small_ntt_tables()[rns_idx]);
    }

    uint64_t Q = 1;
    for(auto &m : mod_high) Q *= m.value();

    for (size_t i = 0; i < n; i++) {
        uint64_t X = 0;
        for (size_t j = 0; j < mod_high.size(); j++) {
            int qj = mod_high[j].value();
            int vj = pt_kq.data()[j * n + i];
            int Mj = Q / qj;
            int invMj = inverse((Mj % qj), qj);
            X = (X + (unsigned __int128)vj * Mj * invMj) % Q;
        }
        int signed_X = (X > Q / 2) ? (int)X - Q : X;
        int clean_m = (signed_X % q_low);
        if (clean_m > q_low / 2) clean_m -= q_low;
        if (clean_m < -q_low / 2) clean_m += q_low;

        for (size_t j = 0; j < mod_high.size(); j++) {
            int qj = mod_high[j].value();
            int limb = clean_m % qj;
            if (limb < 0) limb += qj;
            pt_kq.data()[j * n + i] = limb;
        }
    }

    for (size_t rns_idx = 0; rns_idx < mod_high.size(); rns_idx++) {
        ntt_negacyclic_harvey(pt_kq.data() + (rns_idx * n), context_high->small_ntt_tables()[rns_idx]);
    }
    pt_kq.parms_id() = context_high->parms_id();

    vector<double> result;
    encoder.decode(pt_kq, result);

    for(int i = flag.size(); i < 50; i++){
        cout << result[i] - input[i] << endl;
    }
    return 0;
}


/*

-1.63573e-05
-6.73093e-07
-2.00591e-06
-2.59483e-05
-1.44904e-05
-3.5275e-05
-2.47104e-05

*/CKKS的赛题 属于是wp都还看不太懂 🥲 To be Done